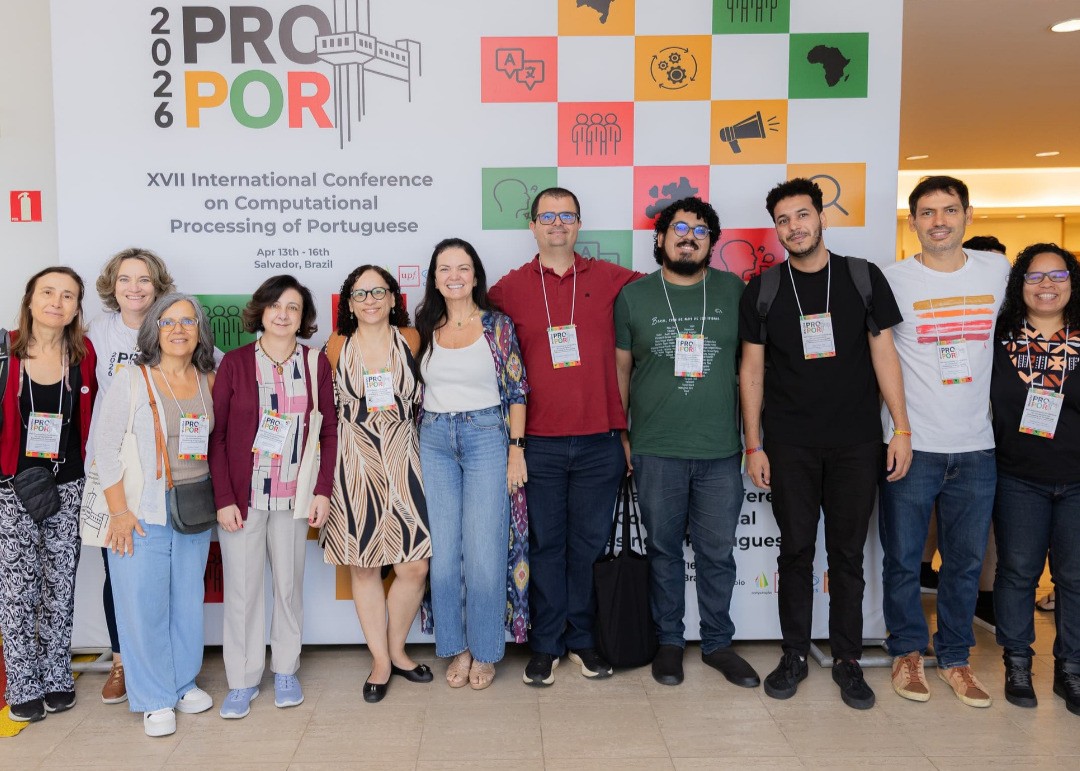
Pesquisadores do INCT TILDIAR apresentaram mais de uma dezena de trabalhos na 17ª edição da PROPOR 2026, International Conference on Computational Processing of Portuguese, realizada entre 13 e 16 de abril, em Salvador. A participação reforça o papel do instituto na definição de métodos, recursos e aplicações para o processamento de linguagem natural (PLN) em português.
Os estudos cobriram desde tarefas clássicas, como parsing, resolução de correferências e desambiguação de sentido, até aplicações atuais, como sumarização automática, análise de sentimento e sistemas de pergunta e resposta. Além disso, os pesquisadores exploraram a geração, a recuperação e a avaliação de linguagem, as tecnologias da fala e as interfaces conversacionais.

Os trabalhos também enfrentam alguns desafios centrais da área. Entre eles, destacam-se a cobertura de dados, a variação do português e o uso de modelos de grande porte em diferentes domínios. Nesse contexto, os resultados mostram avanços no uso de inteligência artificial aplicada ao português, mas também evidenciam limites técnicos e metodológicos.
Segundo a professora Aline Paes, da Universidade Federal Fluminense e membro do TILDIAR, o campo ainda precisa avançar em bases mais sólidas. “Precisamos de mais “corpora e datasets” de qualidade, bem curados, além de avaliação consistente e maior representatividade linguística”, afirma.
Contexto e posicionamento do PROPOR
Criada em 1993, a PROPOR consolidou-se como um dos principais fóruns para a apresentação de resultados de pesquisas acadêmicas e tecnológicas e à integração dos grupos de pesquisa da área, discussão de métodos, recursos e aplicações em Linguística Computacional e em Processamento de Linguagem Natural para a língua portuguesa.
Reunindo a comunidade internacional dedicada aos estudos nessa área, a conferência alterna sua sede entre Brasil, Portugal e Galícia e funciona como espaço estratégico para consolidar práticas, métricas e agendas de pesquisa na área.
Nesse cenário, o INCT atua diretamente na construção de recursos linguísticos, na avaliação de modelos e no uso responsável de IA. A participação na PROPOR 2026 insere o instituto em uma agenda técnica ampla, alinhada aos principais desafios contemporâneos do PLN.
Conheça alguns dos trabalhos do INCT TILDIAR na PROPOR 2026
| Título completo | Autores | Instituições | Contribuições |
|---|---|---|---|
| CoDEl-BR: An Electoral Debate Corpus from Brazilian Municipal Elections | Alessandra Gomes; Aline Paes; Helena Caseli | UFF; UFSCar | Apresenta um corpus inédito com 2.943 segmentos de debates eleitorais de 2024. Viabiliza estudos sobre argumentação e polarização política. |
| LegalSim-PT: Building a Dataset for Legal Document Simplification | Arthur Scalercio; Maria José Finatto; Aline Paes | UFF; UFRGS | Primeiro dataset em larga escala para simplificação de textos jurídicos em português. Contribui para o acesso à justiça. |
| Analysing LLMs for Spelling Normalization of 18th Century Portuguese | Helena Freire Cameron; Aline Paes; Fernanda Olival; Renata Vieira | Univ. Évora; UFF | Avalia LLMs na normalização de textos históricos, evidenciando a superioridade de modelos especializados em português. |
| Gender Identification in Brazilian Portuguese Product Reviews | Tiago de Melo; Carlos Maurício | UEA | Compara modelos clássicos, BERT e LLMs na identificação de gênero em reviews, indicando limites de generalização. |
| Rating–Text Mismatch in Brazilian Portuguese Reviews | Emanuelle Marreira; Tiago de Melo; Carlos Maurício | UEA | Demonstra que LLMs identificam inconsistências entre texto e nota com mais de 90% de F1. |
| Discovery of Legal Patterns in Civil Petitions via LLM | Rhedson Esashika; Carlos Maurício; Tiago de Melo | UEA | Combina extração de fatos com embeddings jurídicos para organizar petições em grupos temáticos. |
| Gendered Stylistic Variation in Brazilian Portuguese Google Play Reviews | Tiago de Melo | UEA | Analisa 76,7 milhões de reviews para identificar padrões estilísticos associados ao gênero dos usuários. |
| Sintomas Linguísticos: RAG e Raciocínio em LLMs em Contextos Médicos | Guilherme V. de Moura; Gabriel Assis; Aline Paes | UFF | Avalia o impacto do idioma (PT vs EN) em LLMs médicos e a inconsistência do uso de RAG em modelos menores. |
| Auditing the Evaluators: Automatic Evaluation in Portuguese Financial Texts | Marina R. Masid; Gabriel Assis; Daniela Vianna; Aline Paes; Altigran S. Silva | JusBrasil; UFF; UFAM | Testa métricas automáticas e LLMs como avaliadores, mostrando fragilidade em textos financeiros. |
| Analysis of Machine Translators on Portuguese Image Captioning Models | Natan Moura; João Gondim; Daniela B. Claro; Babacar Mane | UFBA | Avalia o impacto de tradutores automáticos na geração de descrições de imagens. |
| dialect2vec: Método baseado em vetores para transcrição dialetal | Laila Santos; Daniela B. Claro; Eloize Seno; Rerisson Cavalcante | UFBA; IFSP | Propõe abordagem baseada em bytes para modelar variações fonológicas de dialetos brasileiros. |
| AttentionApp: Tool for Analyzing Transformer Attention Patterns | Ricardo Gomes; Daniela B. Claro | UFBA | Ferramenta interativa para inspeção de padrões sintáticos e semânticos em modelos Transformers. |
| RacismoBR: Dataset for Racist Discourse Detection | João Vítor Vaz; Fabricio Benevenuto; Marcos André Gonçalves | UFMG | Dataset anotado por pesquisadores negros. Mostra que a qualidade da anotação supera a importância da arquitetura do modelo. |