
Uma letra de música pode falar de amor, sofrimento, família ou violência. Nem sempre, porém, esses assuntos aparecem de maneira direta. Metáforas, gírias, jogos de palavras e narrativas podem expressar experiências e conflitos sociais sem mencionar explicitamente os temas abordados.
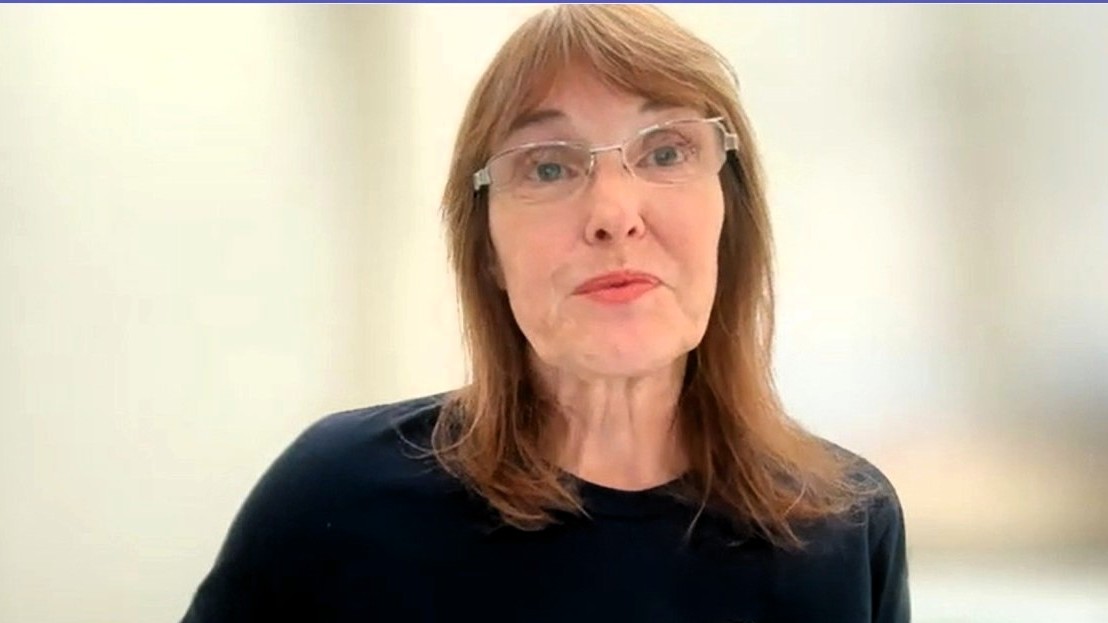
Essa complexidade foi o ponto de partida da apresentação da professora Karin Becker no Café com IA, realizado em 6 de novembro. Pesquisadora do INCT TILDIAR e professora do Instituto de Informática a Universidade Federal do Rio Grande do Sul (UFRGS), ela mostrou como técnicas de Processamento de Linguagem Natural (PLN) e inteligência artificial (IA) podem ajudar a identificar temas em grandes conjuntos de letras musicais e apresentou resultados de pesquisas com os gêneros sertanejo e funk brasileiro.
A questão não é apenas reconhecer palavras que aparecem juntas, mas identificar quando diferentes expressões e histórias tratam de um mesmo assunto. Para isso, os modelos computacionais precisam lidar com os sentidos implícitos e com o contexto em que as letras são produzidas.
O desafio de identificar temas no sertanejo
Um dos estudos apresentados analisou 959 músicas sertanejas. Com o uso de técnicas de modelagem de tópicos, a equipe identificou inicialmente 44 agrupamentos temáticos, posteriormente reunidos em 21 macrotópicos. A avaliação de especialistas confirmou 17 desses grupos.
Os resultados apontaram a recorrência de temas como amor, sofrimento, paixão e desejo. Entretanto, assuntos frequentemente associados ao gênero, como traição, bebida e vida noturna, apareceram de forma fragmentada ou tiveram menor identificação pelos modelos.
O problema está na maneira como as letras expressam seus conteúdos. Um mesmo tema pode aparecer em palavras e narrativas diferentes. Além disso, um termo pode ter sentido literal em determinado trecho e adquirir significado mais amplo em outro contexto.
A pesquisadora citou exemplos em que elementos como natureza, celular ou carro poderiam ser interpretados pelo modelo de maneira literal, embora integrassem narrativas relacionadas a experiências de sofrimento. Por isso, a identificação automática dos agrupamentos não dispensou a avaliação humana.
Do sertanejo ao funk: uma pesquisa também pessoal
O interesse de Karin pelo funk brasileiro começou com uma investigação sobre os discursos relacionados às mulheres nas letras. Na apresentação, ela contou que a escolha do tema também teve uma origem pessoal: a relação com as duas filhas, que se identificavam com o feminismo e, ao mesmo tempo, cantavam e dançavam funk nas festas.
“Eu não entendia por que elas cantavam letras de Funk que objetificam as mulheres, tão alegremente, sendo elas tão feministas”, relatou. A experiência levou Karin a investigar como as mulheres são representadas nas letras e a questionar suas próprias percepções sobre o gênero. Ela reconheceu que, no início do trabalho, também teve dificuldade para compreender os termos e os contextos presentes nas músicas e admitiu ter reproduzido preconceitos.
A pesquisadora chamou atenção para o fato de que o funk é uma voz da periferia. Segundo ela, estudos da sociologia e da antropologia discutem os estereótipos e o preconceito dirigidos às populações periféricas, que cantam sobre aquilo que vivenciam. Karin também observou que o gênero ultrapassou os limites de público que costumavam ser associados a ele e alcançou circulação mainstream e internacional.
A investigação, portanto, não se limitou à identificação de temas relacionados à objetificação e à sexualização das mulheres, violência, drogas ou à ostentação, que compõem o estereótipo do gênero. O objetivo passou a ser compreender a diversidade de discursos presentes nas letras e reconhecer quando diferentes palavras, gírias e narrativas expressam um mesmo assunto.
Um método para ir além das palavras
Para enfrentar esse desafio, a equipe desenvolveu o LLMusic, uma abordagem que utiliza modelos de linguagem de grande porte (LLMs) para interpretar os conteúdos das letras e identificar temas que não são necessariamente evidentes pela repetição de palavras.
O método tem duas etapas. Primeiro, os modelos propõem temas a partir de um conjunto de músicas usado como referência. Depois, esses temas são atribuídos a novas canções ou trechos. A abordagem permite que uma mesma música ou parte dela receba mais de uma classificação, já que diferentes assuntos podem aparecer em um mesmo texto.
Em um primeiro teste, a equipe aplicou o método a 18 músicas que já haviam sido analisadas em um estudo antropológico. A comparação permitiu recuperar temas relacionados a relações familiares, aparência e comportamento das mulheres, sedução, tráfico e consumo de substâncias, além de violência, criminalidade, vida nas favelas e superação de desafios.
Na etapa seguinte,os tópicos foram extraídos de cerca de mil músicas, para poder comparar com outros métodos existentes. O LLMusic identificou 15 temas: sete correspondiam diretamente aos encontrados no conjunto menor, seis eram semelhantes e dois apareceram pela primeira vez. Em comparação, outros métodos testados produziram muito mais agrupamentos, mais fragmentados e temas considerados pouco coerentes.
A diversidade do funk e os limites da classificação automática
Esse trabalho revelou temas que vão além daqueles frequentemente associados ao funk. Relações amorosas, vida nas periferias e reflexões sobre a própria existência também apareceram entre os assuntos identificados. Violência, tráfico e consumo de substâncias foram encontrados, mas tiveram frequência menor do que a esperada pela equipe a partir de determinadas percepções sobre o gênero.
Esse resultado não significa que tais temas estejam ausentes das músicas. Mostra que eles representam apenas parte de um repertório mais amplo de experiências e discursos.
A pesquisa também identificou dificuldades na etapa de classificação dos trechos. Os modelos nem sempre atribuíam corretamente uma letra ao tema correspondente. A equipe testou diferentes configurações e repetiu as consultas para avaliar a consistência das respostas. No entanto, o desempenho variou conforme o assunto e a estratégia utilizada.
Exigir maior concordância entre as respostas podia aumentar a confiabilidade das classificações, mas também deixava mais trechos sem identificação. Em alguns cenários, cerca de 30% das músicas permaneciam sem classificação.
Para Karin, esses resultados mostram que a capacidade dos modelos de linguagem de encontrar padrões não elimina a necessidade de avaliação humana. A interpretação de temas culturais depende de conhecimentos sobre o contexto em que as expressões são utilizadas. Além disso, palavras semelhantes podem assumir sentidos diferentes, enquanto discursos próximos podem ser construídos com vocabulários distintos.
O LLMusic demonstrou potencial para investigar a diversidade temática do funk em escala maior do que seria viável em uma análise manual. Ao mesmo tempo, a experiência evidenciou que a inteligência artificial não interpreta, por si só, todos os sentidos sociais e culturais presentes nas letras. A validação por especialistas continua necessária para avaliar se os temas identificados fazem sentido no universo em que as músicas foram produzidas.
Café com IA e INCT TILDIAR
O Café com IA é uma iniciativa do INCT TILDIAR que promove encontros on-line para discutir pesquisas, aplicações e desafios relacionados à inteligência artificial. A programação aproxima pesquisadores e público interessado no tema, criando espaço para a divulgação científica e o debate sobre os impactos da IA na sociedade.
O Instituto Nacional de Ciência e Tecnologia em Inteligência Artificial Responsável para Linguística Computacional, Tratamento e Disseminação de Informação (INCT TILDIAR) reúne pesquisadores de instituições de diferentes regiões do Brasil. Sediado no Departamento de Ciência da Computação (DCC) da Universidade Federal de Minas Gerais (UFMG), o Instituto desenvolve pesquisas voltadas à inteligência artificial responsável, considerando aspectos como ética, transparência, inclusão, sustentabilidade e impactos sociais dessas tecnologias.