
Depois de apresentar pesquisas voltadas à segurança da inteligência artificial para jovens e aplicações em saúde, esta segunda reportagem sobre os trabalhos do INCT TILDIAR apresentadas no 26º Simpósio Brasileiro de Computação Aplicada à Saúde (SBCAS 2026), destaca estudos que buscam aumentar a confiabilidade dessas tecnologias.
Leia esta e a outra notícia sobre os trabalhos do INCT TILDIAR apresentados no SBCAS 2026.
Da avaliação de modelos de linguagem ao aproveitamento de mensagens de áudio e à recuperação de informações ausentes em bases clínicas, pesquisas mostram como a inteligência artificial vem sendo adaptada para enfrentar desafios concretos da saúde digital.
Realizado no início de junho, em Ouro Preto (MG), o evento reuniu pesquisadores que desenvolvem soluções voltadas ao uso da computação em contextos clínicos e assistenciais. Entre eles, pesquisadores do Instituto Nacional de Ciência e Tecnologia em Inteligência Artificial Responsável para Linguística Computacional, Tratamento e Disseminação de Informação (INCT TILDIAR) apresentaram estudos que abordam diferentes etapas do uso da IA em saúde.
Como avaliar respostas produzidas por inteligência artificial
O professor Leonardo Rocha, da Universidade Federal de São João del-Rei (UFSJ), liderou o estudo “Módulo Integrado para Avaliação Contínua de Modelos de Linguagem em Plataforma de Saúde Digital”. O trabalho foi desenvolvido por Ana Cláudia Machado, junto com os demais professores Elisa Tuler, também da UFSJ, além de Jussara Almeida e Marcos André Gonçalves, da Universidade Federal de Minas Gerais (UFMG), além de Víctor Macul e Olívio Souza, da plataforma Ana Health.
O trabalho apresentou uma ferramenta integrada à Ana Health, dirigida a avaliar continuamente textos produzidos por modelos de linguagem em aplicações de saúde. A aplicação compara conteúdos gerados por diferentes sistemas de IA e também por profissionais humanos, incluindo resumos clínicos, transcrições de consultas e respostas destinadas a pacientes.
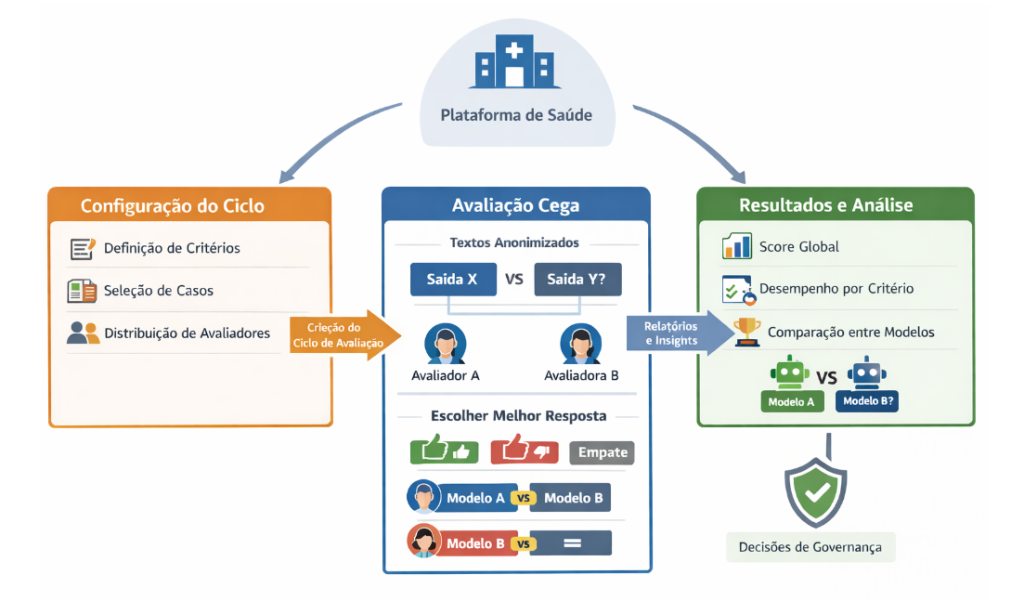
Durante o processo, especialistas analisam os textos sem saber quem produziu cada conteúdo. As avaliações são registradas em um ciclo contínuo que permite comparar diferentes modelos e acompanhar seu desempenho ao longo do tempo.
À medida que modelos de linguagem passam a ser utilizados em atividades clínicas, cresce também a necessidade de monitorar a qualidade dos conteúdos produzidos por esses sistemas. Informações imprecisas ou incompletas podem afetar decisões e processos de atendimento em saúde.
Em vez de desenvolver um novo modelo de linguagem, os pesquisadores concentraram esforços na criação de mecanismos para avaliar, comparar e acompanhar o desempenho das ferramentas já disponíveis. Trata-se de um sistema de auditoria contínua, capaz de apoiar decisões sobre quais modelos podem ser utilizados em diferentes cenários da saúde digital. Sua finalidade é monitorar, validar e calibrar Grandes Modelos de Linguagem (LLMs) em sistemas de telemedicina e telessaúde
Quando os áudios também contam a história do paciente
Desenvolvido pelo Davi Reis, da Universidade Federal de Minas Gerais (UFMG), o estudo “Sumarização Multimodal de Diálogos Clínicos na Atenção Primária Digital: Integrando Mensagens Textuais e Áudios” abordou uma situação comum em serviços digitais de saúde: o uso de mensagens de voz por pacientes.
Em plataformas de atendimento remoto, grande parte da comunicação ocorre por aplicativos de mensagens. Entretanto, muitas soluções de inteligência artificial analisam apenas textos escritos, deixando de considerar informações presentes nos áudios enviados pelos usuários.
Para enfrentar esse problema, os pesquisadores desenvolveram um pipeline multimodal capaz de integrar mensagens de voz e texto ao processo de sumarização de históricos clínicos. O objetivo foi aproveitar informações clínicas presentes nos áudios para enriquecer os resumos utilizados pelos profissionais de saúde.
O trabalho analisou 706 arquivos de áudio fornecidos pela Ana Health. A equipe desenvolveu um processo para identificar gravações adequadas à transcrição, converter essas mensagens em texto e incorporar as informações ao conjunto de dados utilizado na geração dos resumos clínicos.
Em uma avaliação qualitativa preliminar, os pesquisadores observaram que a inclusão dos áudios produziu resumos mais detalhados e contextualizados. As versões enriquecidas incorporaram informações clínicas relatadas oralmente pelos pacientes que não apareciam nas mensagens de texto.
Segundo os autores, a abordagem pode contribuir para que profissionais de saúde tenham acesso a uma visão mais abrangente das informações compartilhadas durante o acompanhamento dos pacientes. O uso de mensagens de voz pode ampliar a inclusão de pessoas que utilizam o áudio como principal forma de comunicação em ambientes digitais de saúde.
Lidando com dados clínicos incompletos
“MIST-Saúde: Uma Ferramenta Flexível de Imputação Semântica de Dados Clínicos Tabulares” concentrou-se em outro desafio recorrente da saúde digital: Como recuperar informações ausentes em bases de dados clínicas.
O trabalho foi desenvolvido por Arthur Henrique Quaresma, do DCC UFMG, em colaboração com outros pesquisadores da UFMG, mas também da Universidade Federal de São João del-Rei (UFSJ) e da Universidade Federal da Fronteira Sul (UFFS).
Falhas de coleta, integração de sistemas e registros incompletos podem comprometer análises e reduzir a precisão de modelos de inteligência artificial utilizados em pesquisas e aplicações clínicas.
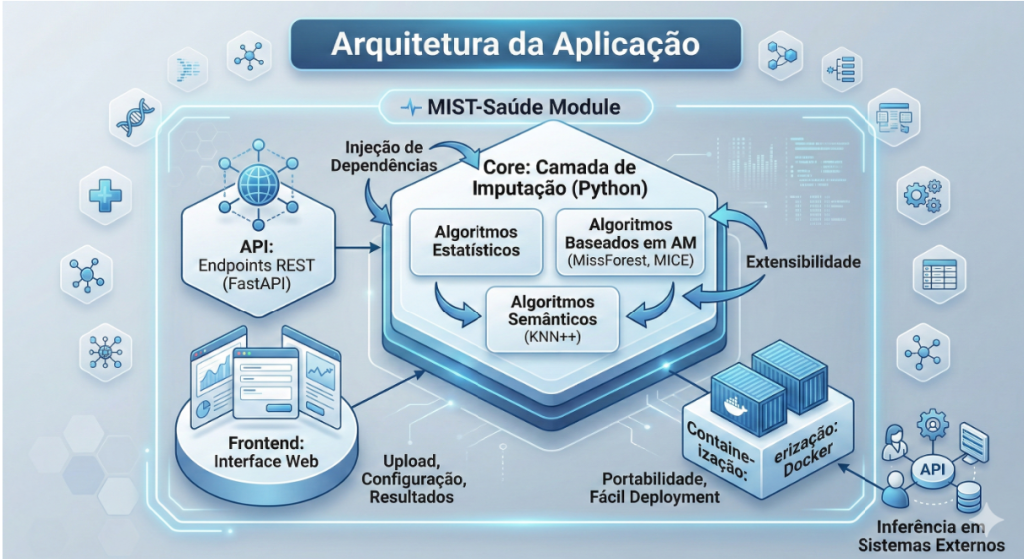
O MIST-Saúde é uma ferramenta voltada à imputação semântica de dados clínicos tabulares. A proposta combina métodos estatísticos e modelos fundacionais para reconstruir informações ausentes em conjuntos de dados. O objetivo é produzir preenchimentos mais coerentes com o contexto clínico disponível.
Para testar a ferramenta, os pesquisadores utilizaram uma base multicêntrica com aproximadamente 16 mil pacientes hospitalizados por COVID-19 em 25 hospitais brasileiros. Segundo o trabalho, cerca de 16% das informações estavam ausentes.
Os autores argumentam que melhorar a qualidade dos dados disponíveis é uma etapa importante para aumentar a confiabilidade de modelos preditivos e apoiar futuras aplicações de inteligência artificial em saúde.
Referências
Módulo Integrado para Avaliação Contínua de Modelos de Linguagem em Plataforma de Saúde Digital
Ana Claudia Machado (UFSJ), Elisa Tuler (UFSJ), Víctor Macul (Ana Health), Olívio Souza (Ana Health), Jussara Almeida (UFMG), Marcos André Gonçalves (UFMG) e Leonardo Rocha (UFSJ).
Anais do Simpósio Brasileiro de Computação Aplicada à Saúde (SBCAS 2026).
Sumarização Multimodal de Diálogos Clínicos na Atenção Primária Digital: Integrando Mensagens Textuais e Áudios
Davi Reis, Anderson A. Ferreira, Washington Cunha, Victor Macul, Olivio Neto, Jussara Almeida, Leonardo Rocha, Marcos André Gonçalves/Autores vinculados à UFMG, UFSJ, Ana Health e instituições parceiras
Em: Anais do Simpósio Brasileiro de Computação Aplicada à Saúde (SBCAS 2026).
MIST-Saúde: Uma Ferramenta Flexível de Imputação Semântica de Dados Clínicos Tabulares
Arthur Henrique Quaresma, Caio Fabri, Davi Augusto Rodrigues, Izadora Ganem, Guilherme Dal Bianco, José Carlos Serufo Filho, Leonardo Rocha, Milena Marcolino e Marcos André Gonçalves.
Anais do Simpósio Brasileiro de Computação Aplicada à Saúde (SBCAS 2026).
Leia a Parte 1 desta notícia em: Pesquisas do INCT TILDIAR discutem como tornar a IA mais segura; para jovens e no contexto da saúde

