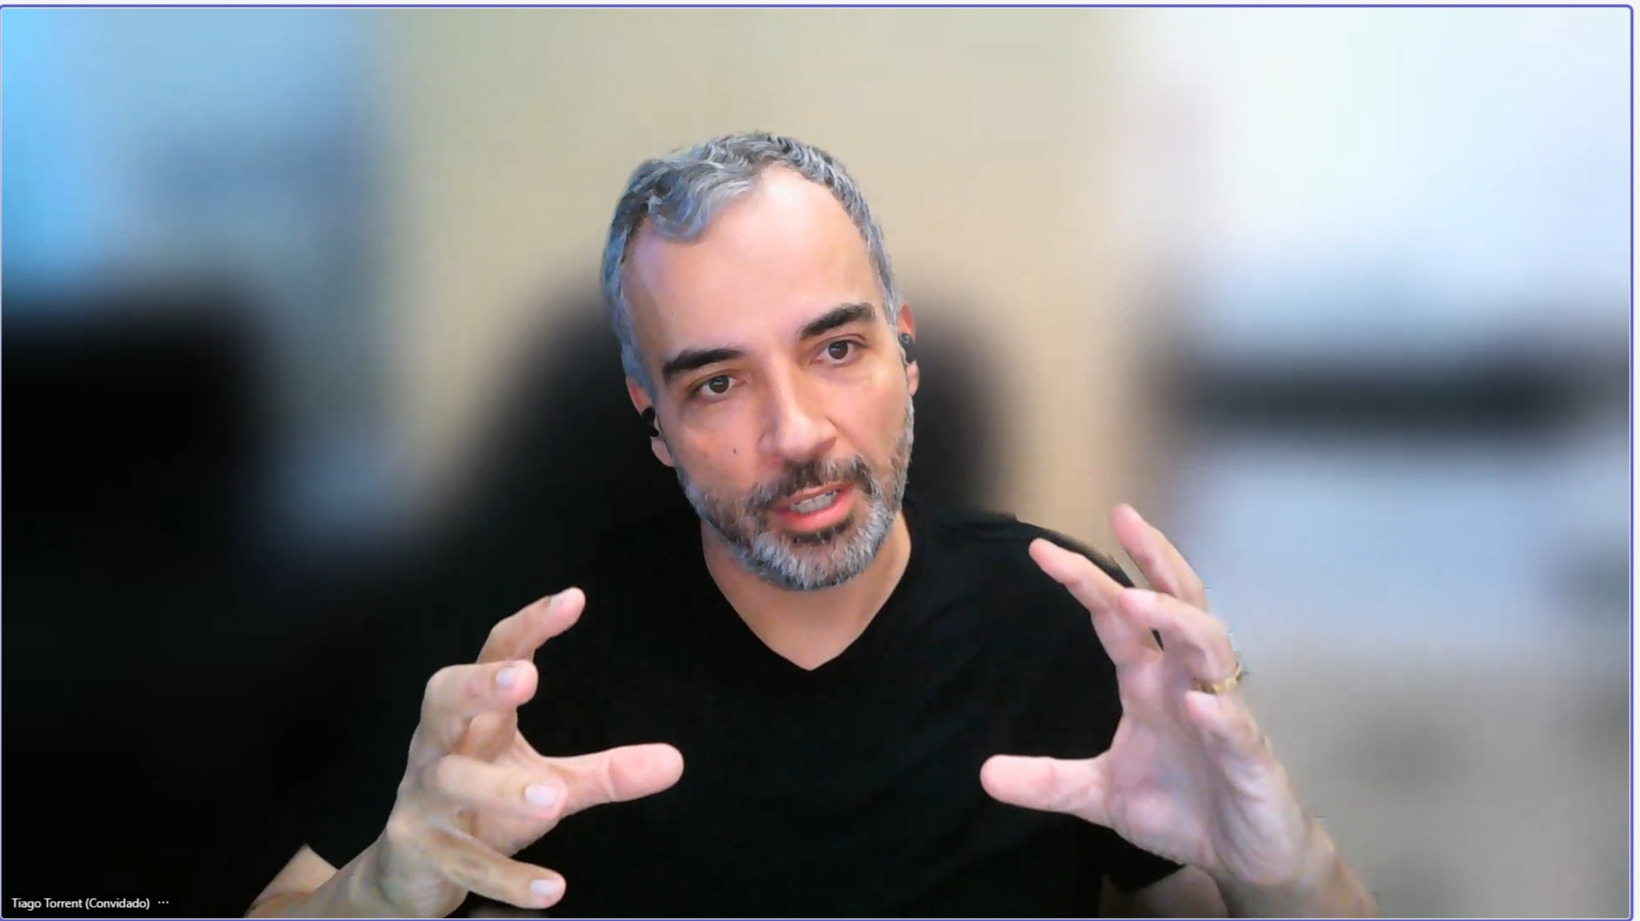
Tiago Torrent, no Café com IA, analisou a relação entre seleção de dados, representação da diversidade brasileira e soberania no desenvolvimento de sistemas de inteligência artificial – Reprodução de tela, 28/8/2026
Desenvolver modelos de inteligência artificial em português com dados nacionais não basta para garantir que esses sistemas representem “o Brasil”. Antes do treinamento, é preciso decidir quais variedades linguísticas, grupos sociais e referências culturais estarão presentes nos dados. É necessário também ter clareza sobre como os dados foram coletados, escolhidos e organizados e com qual objetivo.
Esse foi o aspecto que orientou a palestra “Dados pra quê? IA pra quem? Viés, soberania e o papel da curadoria humana de datasets”, do professor Tiago Timponi Torrent, da Universidade Federal de Juiz de Fora (UFJF), na 3ª edição do Café com IA.
O evento mensal on-line é promovido pelo Instituto Nacional de Ciência e Tecnologia em Inteligência Artificial Responsável para Linguística Computacional, Tratamento e Disseminação de Informação (INCT TILDIAR), em 28 de agosto, on-line.
O pesquisador apresentou seus estudos acerca da relação entre dados, representatividade, viés e soberania no desenvolvimento de sistemas de IA.
Dados sozinhos não representam o Brasil
Segundo ele, existe uma diferença importante entre os termos língua e linguagem. De uma forma resumida, modelos de língua não aprendem diretamente a capacidade humana de produzir e compreender linguagem. Por isso, a ideia de transferir o que um modelo aprende sobre os padrões observados em uma língua para outra não vem sem riscos de reproduzirem associações, ausências e vieses presentes nesses dados.
A questão se torna mais complexa quando se considera a diversidade do português brasileiro. Existem diferenças regionais e sociais no modo como as pessoas usam a língua. Assim, um conjunto de dados produzido no Brasil ou disponível na internet não é, por si só, representativo da sociedade brasileira.
Curadoria humana define o que entra nos dados
Para Torrent, é nesse ponto que entra a curadoria humana. Antes de utilizar um dataset, um conjunto de dados organizados, é necessário conhecer sua origem, finalidade, composição, condições de uso e procedimentos adotados em sua produção. A documentação também ajuda a identificar limites e possibilidades de reutilização dos dados.
Para ele, entre outros recursos, os data statements e os datasheets for datasets, podem ser utilizados para documentar características e contexto de conjuntos de dados.
Soberania também depende dos dados
A soberania em inteligência artificial é um outro aspecto sobre o qual Torrent recomenda reflexão. Ele concorda com a ideia de que a infraestrutura computacional é necessária, “mas não é suficiente!”, diz. Modelos nacionais dependem igualmente de dados adequados aos objetivos que o país pretende alcançar.
O Brasil já possui datasets prontos para uso e possui também uma base científica que pode vir a contribuir nesse esforço, desde que reenquadrada para este fim. Pesquisas em Linguística produziram acervos que podem ser aproveitados, desde que sejam avaliadas as condições éticas, legais e técnicas de reutilização e disponibilização desses acervos como datasets, o que caracteriza uma finalidade diferente daquela para a qual muitos desses materiais foram pensados.
A palestra também apresentou dados sobre a disponibilidade de recursos em português na plataforma Hugging Face e discutiu uma iniciativa do INCT TILDIAR para organizar e disponibilizar datasets com curadoria humana voltados ao português brasileiro. A questão, portanto, não começa com qual modelo de IA utilizar, mas com quais dados serão escolhidos para ensinar esse modelo sobre o Brasil.
Café com IA
O Café com IA é uma série de encontros técnicos online e mensais do INCT TILDIAR. A iniciativa apresenta pesquisas e promove a troca de experiências entre pesquisadores sobre inteligência artificial e suas aplicações. Aberto a pesquisadores, estudantes e todos os interessados no tema de cada encontro, os encontros têm como objetivo aproximar diferentes áreas do conhecimento e promover o debate sobre os impactos sociais, éticos e tecnológicos da IA.
Assista no Youtube
A gravação da 3ª edição do Café com IA será publicada no canal do INCT TILDIAR no YouTube (@INCTILDIAR).
Interessou pelo assunto?
Produzimos um artigo de divulgação científica, mais detalhado e com mais informações sobre seleção de dados, representação da diversidade brasileira e soberania no desenvolvimento de sistemas de inteligência artificial, apresentados por Tiago Torrent no Café com IA de agosto (Acesse aqui).