A inteligência artificial (IA) já faz parte de atividades cotidianas, do uso de celulares e navegadores à análise de informações em áreas como saúde, educação e agricultura. Por trás dessas aplicações estão os dados usados para treinar e avaliar os sistemas.
Mas quem escolhe esses dados? O que ocorre quando eles não representam a diversidade da língua portuguesa e da sociedade brasileira? E como evitar que preconceitos presentes nas informações sejam incorporados aos sistemas?
Essas questões estarão no centro da 3ª edição do Café com IA, promovido pelo Instituto Nacional de Ciência e Tecnologia em Inteligência Artificial Responsável para Linguística Computacional, Tratamento e Disseminação de Informação (INCT TILDIAR). O encontro será online e gratuito, no dia 28 de agosto, sexta-feira, às 16h. As inscrições estão abertas.
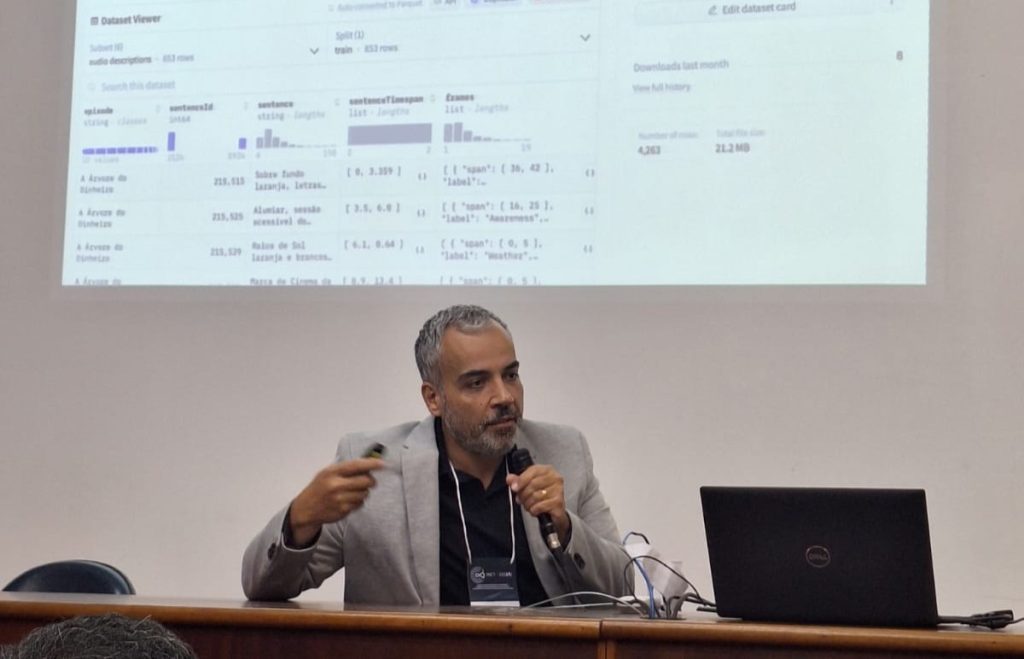
O convidado é o professor Tiago Timponi Torrent, da Universidade Federal de Juiz de Fora (UFJF), onde coordena o Laboratório FrameNet Brasil de Linguística Computacional, e pesquisador do INCT TILDIAR. Ele apresentará a palestra “Dados pra quê? IA pra quem? Viés, soberania e o papel da curadoria humana de datasets”.
Mais dados não garantem IA melhor
A ideia de que uma inteligência artificial melhora à medida que recebe mais dados é comum. A quantidade, porém, não é suficiente para garantir bons resultados. Os dados utilizados pelo sistema precisam representar o problema que ele pretende resolver.
Por isso, a curadoria humana de datasets ocupa papel central no desenvolvimento de aplicações de IA. A curadoria envolve selecionar, organizar, classificar e revisar conjuntos de dados usados para treinar, testar ou avaliar sistemas. Em aplicações de linguagem, esse trabalho também pode incluir a identificação de significados e relações presentes nos textos.
Sem esse cuidado, erros, lacunas e vieses existentes nos dados podem chegar aos sistemas de inteligência artificial.
Não basta reconhecer palavras
Para que uma IA compreenda uma frase, não basta reconhecer as palavras. É preciso considerar significados, relações entre conceitos e contextos de uso. É nesse ponto que entra a Linguística Computacional, área que aproxima conhecimentos da Linguística e da Computação para desenvolver tecnologias capazes de processar a linguagem humana.
“Os linguistas ajudam a incorporar aos sistemas informações que vão além das palavras. Significados, relações entre conceitos e contextos de uso também fazem parte desse processo”, afirma Torrent.
Ele cita como exemplo os avanços do Laboratório FrameNet Brasil de Linguística Computacional, da UFJF. Em parceria com a Vital Strategies Brasil, o grupo desenvolveu uma aplicação de IA para estimar a subnotificação de casos de violência contra mulheres e emitir alertas para profissionais de saúde diretamente no prontuário eletrônico das pacientes.
Para isso, os pesquisadores analisaram e anotaram milhares de frases extraídas de prontuários do e-SUS e de notificações do SINAN. A partir dessas anotações humanas, o sistema aprendeu a reconhecer relações de significado associadas a situações de violência.
A aplicação pode ajudar a identificar padrões que indiquem casos não registrados nas estatísticas oficiais, além de contribuir para o acolhimento e o encaminhamento das vítimas no sistema público de saúde. O exemplo mostra como a qualidade, a organização e a interpretação dos dados podem determinar o desempenho de uma aplicação de IA.
Dados e tecnologia também envolvem soberania
A forma como um país produz, organiza e utiliza seus dados está ligada à sua capacidade de desenvolver tecnologias próprias. É nesse ponto que a discussão sobre dados se aproxima da soberania digital.
O conceito envolve a capacidade de um país tomar decisões sobre suas tecnologias, proteger informações estratégicas e desenvolver sistemas alinhados às suas necessidades. Envolve também representatividade: dados usados no treinamento de modelos não são automaticamente representativos das variantes de uma língua e das diferentes culturas que elas expressam.
A partir dessa visão, Torrent avalia que o Brasil ainda precisa ampliar sua capacidade de produzir tecnologia e não apenas consumir soluções desenvolvidas em outros países. A dependência tecnológica pode limitar as decisões sobre como sistemas de IA serão desenvolvidos e utilizados, além de trazer o risco de importar vieses presentes em outras culturas para os modelos usados no país.
Essa questão também alcança áreas como saúde, educação e agricultura. No caso da saúde, por exemplo, sistemas de IA podem analisar grandes volumes de informações e identificar padrões que apoiem decisões.
Por isso, discutir quem produz os dados, como eles são organizados e quem desenvolve as tecnologias também significa discutir a capacidade brasileira de decidir como a inteligência artificial será utilizada.
Café com IA
O Café com IA é uma série de encontros técnicos online e mensais do INCT TILDIAR. A iniciativa apresenta pesquisas e promove a troca de experiências entre pesquisadores sobre inteligência artificial e suas aplicações.
Os encontros também aproximam diferentes áreas do conhecimento e permitem discutir os impactos sociais, éticos e tecnológicos da IA. O encontro é aberto a pesquisadores, estudantes e todos os interessados no tema.
Serviço | 3ª edição do Café com IA
Palestra: “Dados pra quê? IA pra quem? Viés, soberania e o papel da curadoria humana de datasets”
Palestrante: Prof. Tiago Timponi Torrent (UFJF / FrameNet Brasil)
Realização: INCT TILDIAR
Formato: Online e gratuito
Data: 28 de agosto de 2026, sexta-feira
Horário: 16h, horário de Brasília
Inscrições: abertas a todos os interessados, mediante preenchimento do formulário de inscrição.
Após a inscrição, os participantes receberão por e-mail as informações para acesso à transmissão e as demais orientações. O evento terá certificado mediante comprovação de presença.