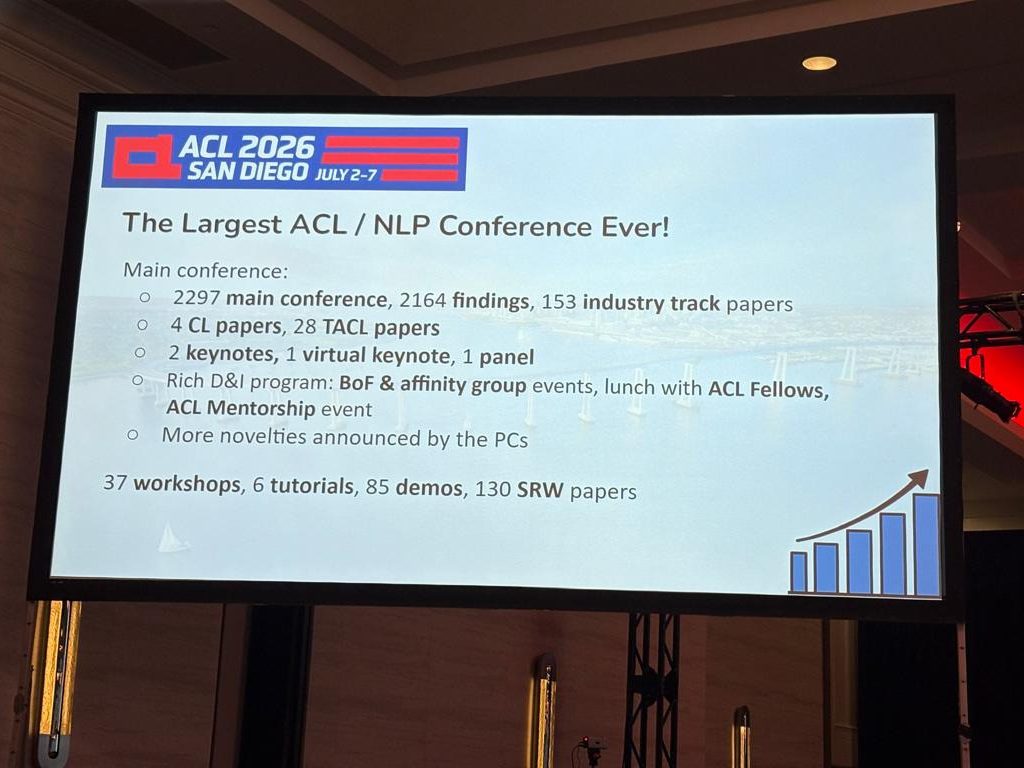
O Instituto Nacional de Ciência e Tecnologia em Inteligência Artificial Responsável para Linguística Computacional, Tratamento e Disseminação de Informação (INCT TILDIAR) ampliou sua presença internacional durante a 64ª Reunião Anual da Association for Computational Linguistics (ACL 2026), realizada entre os dias 2 e 7 de julho, em San Diego (EUA).
Considerada a principal conferência mundial de Linguística Computacional e Processamento de Linguagem Natural (PLN), a ACL reúne milhares de pesquisadores de diversos países e adota um processo altamente seletivo para a publicação de artigos científicos.
Na edição de 2026, o INCT TILDIAR contribuiu tanto para a produção científica quanto para a organização da conferência. Dois artigos completos desenvolvidos por pesquisadores da rede foram aceitos na trilha principal. Além disso, integrantes do instituto exerceram funções estratégicas na coordenação e na avaliação internacional dos trabalhos submetidos.
Os estudos abordam um tema comum: a confiabilidade de modelos de linguagem. Um deles propõe uma nova forma de avaliar a calibração das estimativas de confiança produzidas pelos modelos. O outro investiga se respostas corretas em tarefas jurídicas são realmente sustentadas por um processo de raciocínio consistente.
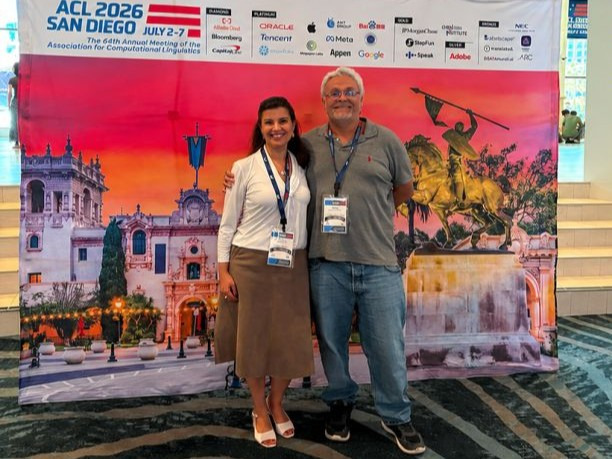
Entre as funções de liderança, a professora Viviane Pereira Moreira (UFRGS), pesquisadora do INCT TILDIAR, atuou como Program Chair, integrando a coordenação responsável pela avaliação e seleção dos artigos científicos da ACL 2026.
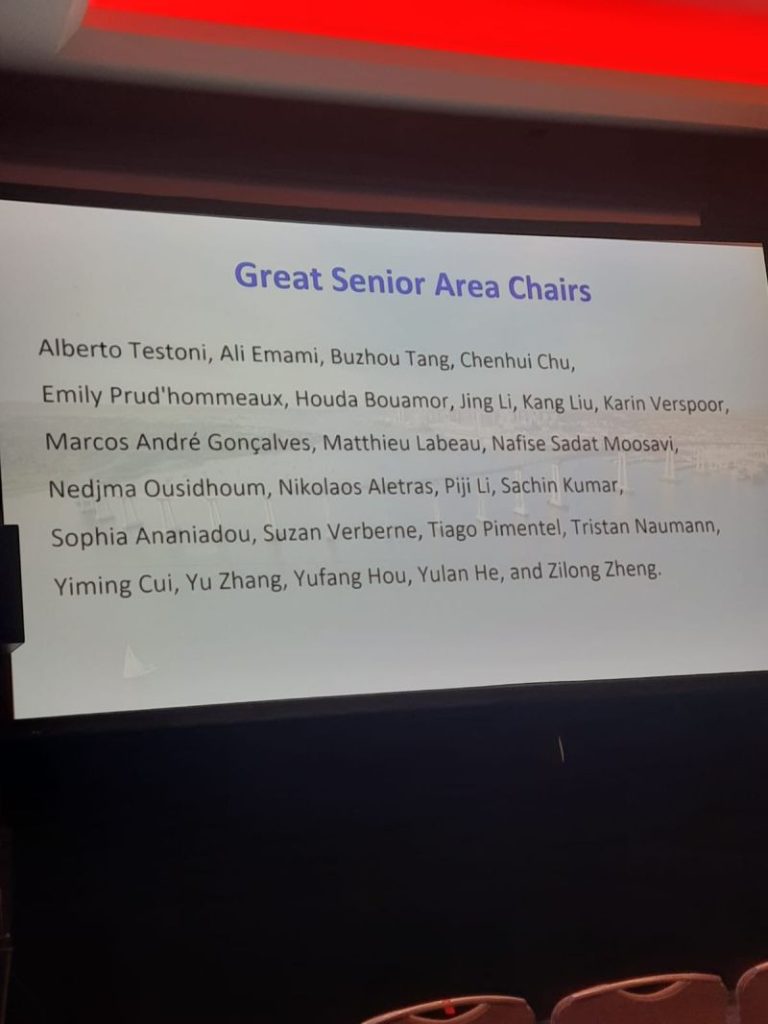
Outro destaque foi o reconhecimento concedido ao professor Marcos André Gonçalves (UFMG), coordenador do INCT TILDIAR, com a distinção de Great Senior Area Chair. A homenagem é concedida a um grupo restrito de pesquisadores que se destacam na condução da revisão científica, coordenando dezenas de revisores, mediando pareceres divergentes e auxiliando na seleção dos trabalhos que compõem o programa técnico da conferência.
“Atuar como Senior Area Chair significa construir consenso entre dezenas de revisores, analisar casos complexos, comparar artigos excelentes entre si e, ao final, ordená-los segundo a qualidade científica percebida. É uma tarefa tão desafiadora quanto necessária em uma conferência desse porte”, afirma Marcos André Gonçalves.
A participação na ACL 2026 reforça a inserção internacional do INCT TILDIAR e evidencia a contribuição da rede para o avanço da pesquisa em Inteligência Artificial e Processamento de Linguagem Natural, além do papel de seus pesquisadores na organização das principais conferências científicas da área.
Conheça os dois trabalhos apresentados na ACL 2026
Alta precisão pode esconder modelos excessivamente confiantes
Modelos de linguagem costumam ser avaliados por métricas, como acurácia e F1-score, que combinam precisão e revocação. Entretanto, um estudo desenvolvido por pesquisadores do INCT TILDIAR, vinculados a UFMG, UFSJ e Unicamp, mostrou que o bom desempenho nessas medidas não garante que o modelo seja confiável.
Mesmo quando acertam a maior parte das respostas, muitos modelos permanecem excessivamente confiantes em previsões incorretas. Este fenômeno é conhecido como overconfidence. O problema é que as métricas usualmente usadas para avaliar calibração, podem mascarar esse comportamento quando a acurácia é muito elevada. No contexto da Computação, calibrar é um processo que usa dados reais para regular um simulador, para que o resultado final seja o mais fiel à realidade possível.
Para investigar essa limitação, os pesquisadores compararam modelos baseados em redes neurais de atenção (Transformers), incluindo tanto grandes modelos de linguagem (LLMs) quanto modelos menores (SLMs). Como referência tradicional de precisão e confiabilidade, eles utilizaram a técnica estatística de regressão logística.
Como alternativa, o artigo apresenta o Balanced Brier Score (BBS), uma adaptação do Brier Score que avalia o modelo linguístico de uma forma mais equilibrada. O Brier Score tradicional é a ferramenta mais usada na ciência para medir a chance de um evento binário acontecer, como a previsão de chuva (vai chover ou não). A nova versão modificada calcula o peso de acertos e erros na mesma proporção, para garantir uma análise mais compatível com seu desempenho, revelando limitações que permanecem ocultas nas métricas tradicionais.
A proposta dessa nova métrica é melhorar a avaliação de sistemas de Inteligência Artificial em áreas onde a margem de erro não pode falhar. Como no caso de decisões importantes como diagnósticos médicos, moderação de conteúdos impróprios, buscas de informações e tarefas de classificação automática.
Resposta correta nem sempre significa raciocínio correto
Até que ponto os grandes modelos de linguagem realmente raciocinam ao resolver problemas jurídicos? Segundo um estudo de e colaboradores, liderado pelo professor do DCC UFMG e também membro do INCT TILDIAR, apresentado na conferência, avaliar apenas a resposta final pode superestimar a capacidade desses sistemas. Isso acontece porque erros graves podem surgir escondidos ao longo do processo de pensamento.
Até que ponto os grandes modelos de linguagem (LLMs) realmente raciocinam ao resolver problemas jurídicos?
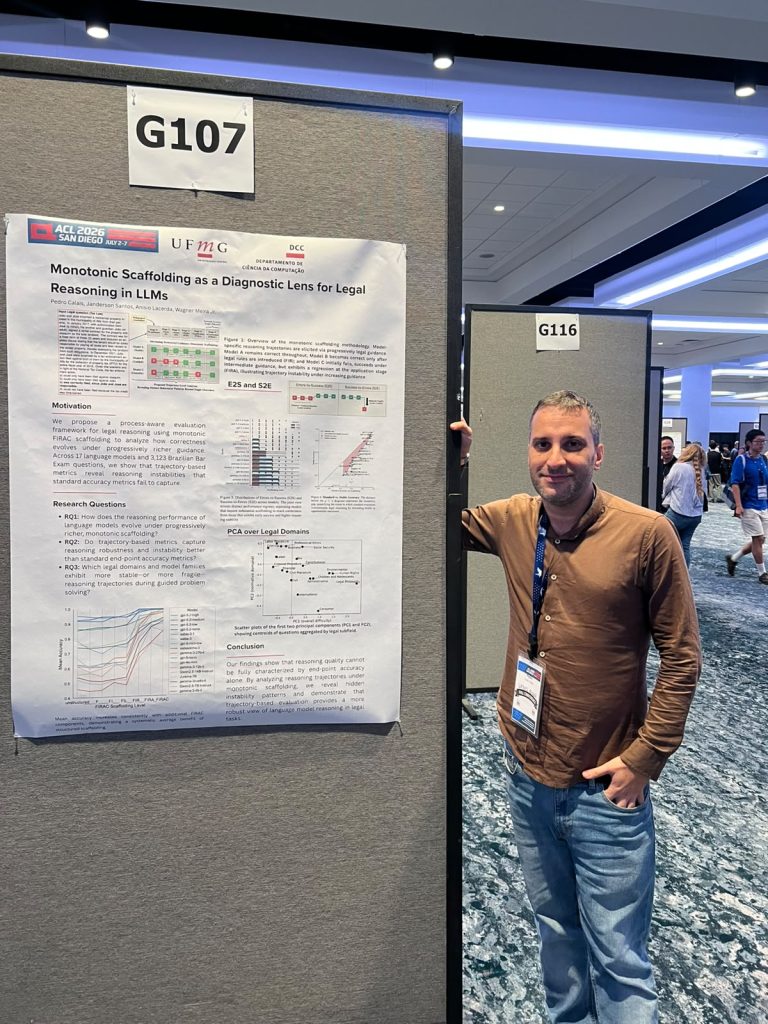
Um estudo de Pedro Calais (foto ao lado) e colaboradores, liderado pelo professor Wagner Meira Jr, do DCC UFMG e pesquisador do INCT TILDIAR, mostra que avaliar apenas a resposta final pode superestimar a capacidade desses sistemas de inteligência artificial.
Segundo os pesquisadores, erros relevantes podem permanecer ocultos.
Para investigar esse comportamento, eles utilizaram 3.123 questões do Exame da OAB, acompanhadas de explicações feitas por especialistas.
Cada problema foi dividido usando o método FIRAC, que organiza o raciocínio jurídico em cinco etapas: os fatos, “Issue” ou questão em debate, a regra legal, a aplicação da lei e a conclusão.
Essa estrutura simplifica a montagem do processo jurídico e, depois, a leitura que será feita pelo examinador ou juiz. Como o argumento segue uma linha previsível e bem amarrada, a comunicação fica mais limpa, aumentando as chances de aceitação da tese.
O FIRAC permite fornecer informações aos modelos de linguagem de forma progressiva e observando como o raciocínio evoluiu em cada etapa.
Os resultados mostram que diversos modelos alteram suas respostas à medida que recebem novas informações. Isso revela instabilidades que permanecem invisíveis quando olhamos apenas para o resultado final.
Para tornar essa avaliação mais rigorosa, os pesquisadores desenvolveram uma estratégia para acompanhar essa evolução, baseada em três novas métricas: a Convergência (quando a IA corrige um erro e passa a acertar), a Degradação (quando ela se confunde e passa a errar) e a Robustez (quando ela mantém a resposta correta do início ao fim).
Dessa forma, a pesquisa apresentou uma nova possibilidade de identificar o ponto exato onde o comportamento da IA muda. Segundo os autores, a metodologia pode orientar o desenvolvimento de sistemas mais transparentes e confiáveis para aplicações no setor jurídico.
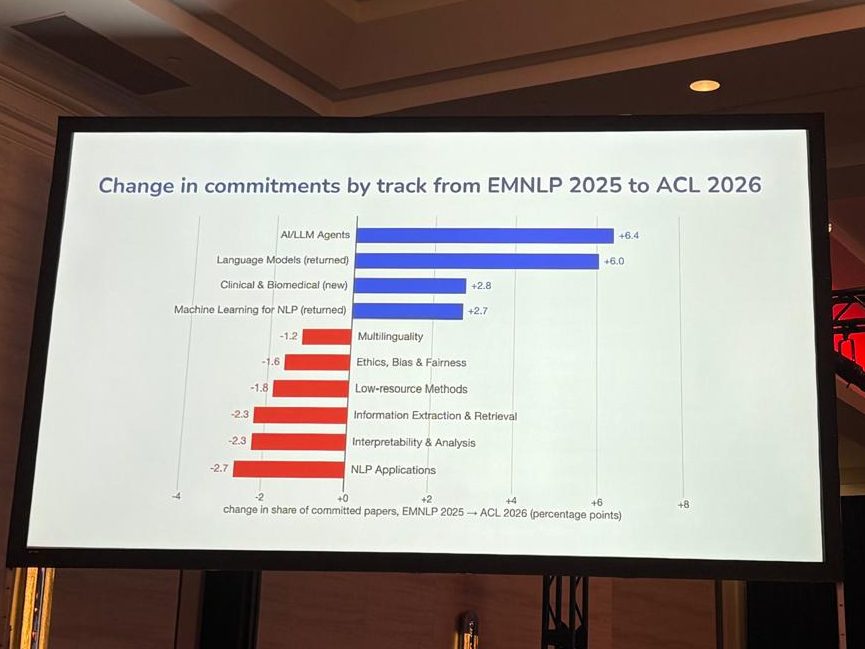
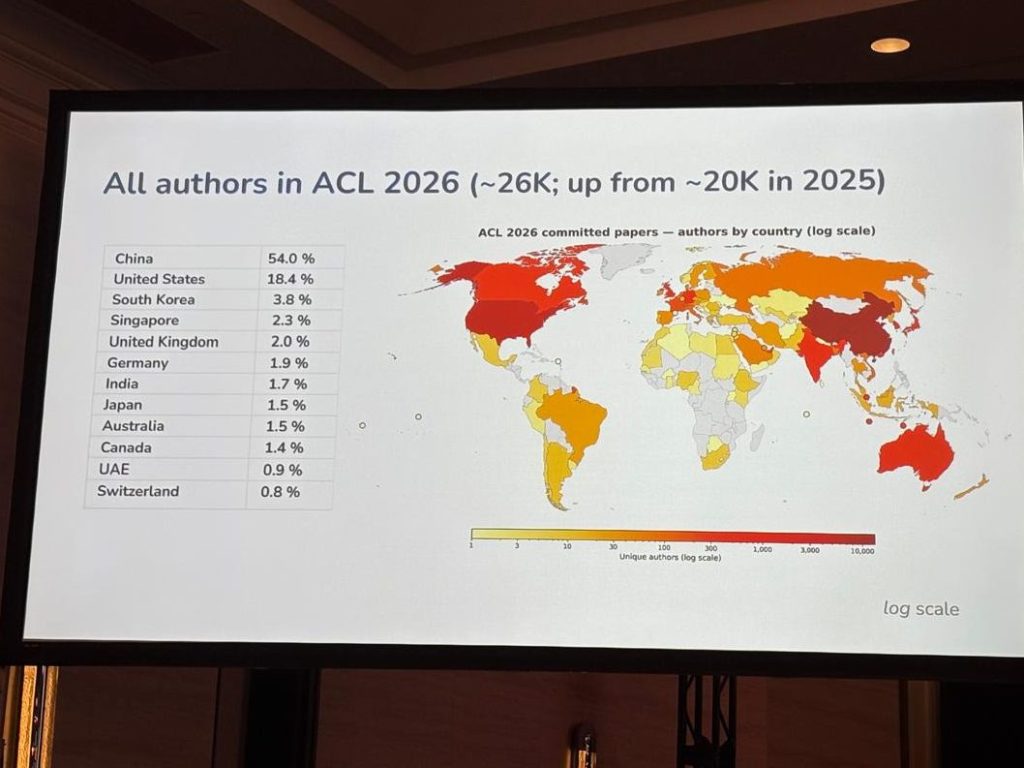
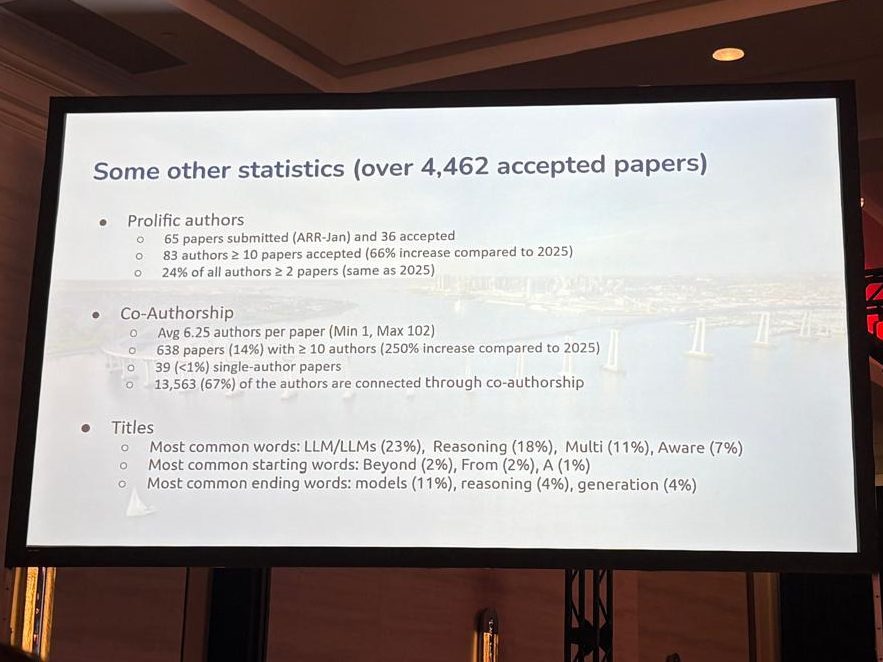
Conheça alguns números do evento
Leia o artigo original
When High Accuracy Hides Poor Calibration: Rethinking Confidence Evaluation in Transformer-Based Text Classification with Balanced Brier Score. Guilherme Fonseca (UFMG), Gabriel Prenassi (UFSJ), Washington Cunha (Unicamp), Leonardo Chaves Dutra da Rocha (UFSJ) e Marcos André Gonçalves (UFMG). Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (ACL 2026). https://aclanthology.org/2026.acl-long.2128
Monotonic Scaffolding as a Diagnostic Lens for Legal Reasoning in LLMs. Pedro Calais, Janderson Santos, Anisio Lacerda e Wagner Meira Jr. (UFMG). Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (ACL 2026). https://aclanthology.org/2026.acl-long.2166