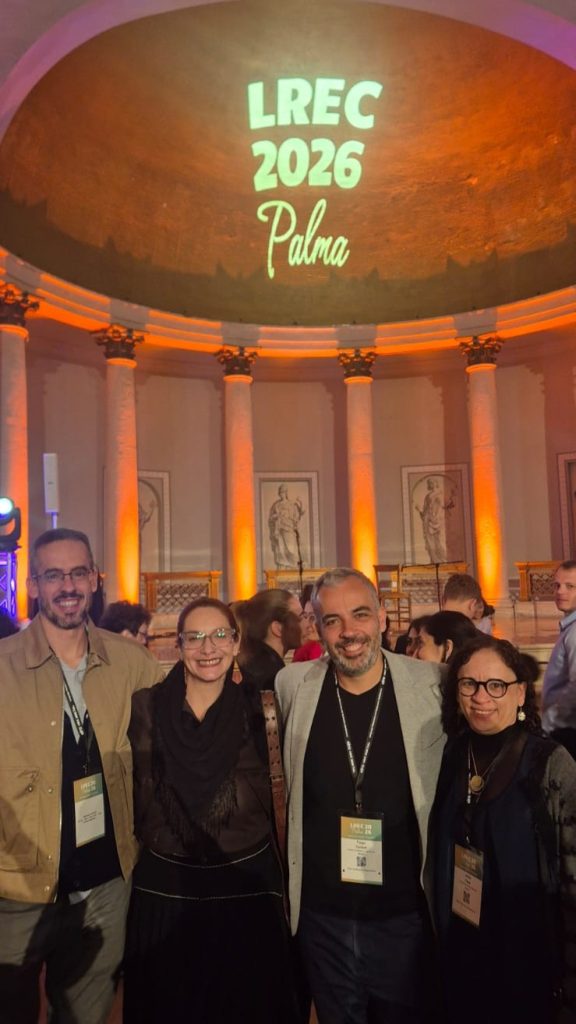
Os pesquisadores Pedro Olmo (UFMG), Livy Real (UFAM), Tiago Torrent (UFJF) e Aline Paes (UFF), nesta ordem na foto ao lado, participaram do LREC 2026 (Language Resources and Evaluation Conference), realizado em Palma de Maiorca, na Espanha.
A conferência reúne pesquisadores de Processamento de Linguagem Natural (PLN), linguística computacional, fala e multimodalidade, com foco no desenvolvimento, avaliação e compartilhamento de recursos linguísticos, além do fortalecimento de colaborações internacionais.
Nesta edição da Newsletter, destacamos três trabalhos apresentados no evento. Embora abordem desafios distintos, eles convergem em um ponto: ampliar recursos, infraestrutura e avaliação responsável para aplicações de linguagem.
O que funcionou — e o que limitou — o OpenCor
A pesquisadora Livy Real, da Universidade Federal do Amazonas (UFAM), participou do workshop LANLP (Latin American Natural Language Processing), voltado à integração entre comunidades ibéricas e latino-americanas de PLN. Em coautoria com Valeria de Paiva, ela apresentou o trabalho “OpenCor: Latin American and Iberian Languages Open Corpora Forum”.
O estudo revisitou a trajetória do OpenCor, iniciativa colaborativa ativa entre 2018 e 2025 voltada à criação, anotação e manutenção de corpora abertos para línguas latino-americanas e ibéricas. O trabalho ofereceu uma análise histórica e crítica de uma experiência já encerrada.
Foram discutidos avanços, aprendizados e limites do OpenCor, incluindo dificuldades de financiamento, continuidade institucional e manutenção do engajamento de comunidades distribuídas, desafios recorrentes, sobretudo em línguas minorizadas ou com poucos recursos computacionais.
Durante o LANLP, também entraram em debate temas como governança, modelos de linguagem, infraestrutura computacional e cooperação científica regional.
Primeiro corpus aberto para metáforas em português brasileiro
Outro trabalho apresentado no LREC 2026 foi “Meta4XNLI-ptBR: Brazilian Portuguese Extension of Meta4XNLI Corpus”, desenvolvido por pesquisadores da UFSCar e da UFF, com participação da pesquisadora , Aline Paes (UFF), e coordenado pela professora Helena Caseli (UFSCar), também do INCT.
O estudo apresenta o primeiro corpus aberto anotado para detecção de metáforas em português brasileiro, preenchendo uma lacuna importante para tarefas de PLN, como tradução automática, análise de sentimentos e interpretação semântica.
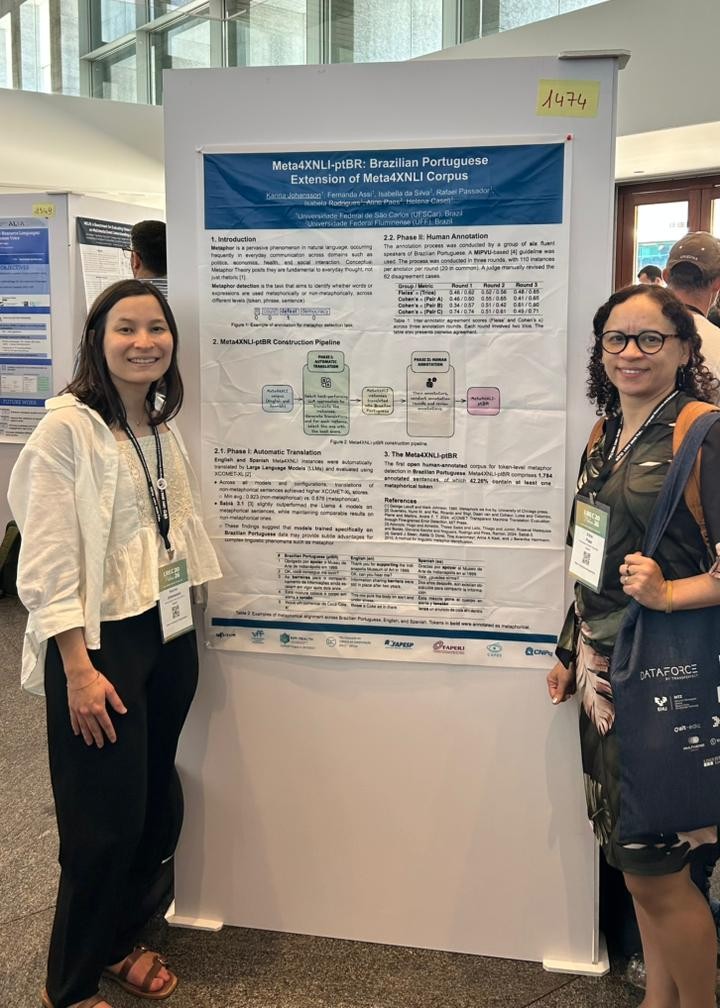
Para construir o corpus, os pesquisadores propuseram um pipeline que combina tradução automática por modelos de linguagem com anotação manual baseada em protocolos adaptados do MIPVU e do Meta4XNLI.
O recurso final reúne 1.784 sentenças anotadas manualmente, das quais 42,26% apresentam ao menos um elemento metafórico.
Segundo os autores, o Meta4XNLI-ptBR é o primeiro recurso aberto desse tipo para o português brasileiro.
O estudo é assinado também por Karina Mayumi Johansson (na foto ao lado), Fernanda Assi, Isabella da Silva, Rafael Passador, Isabela Rodrigues.
Benchmark para avaliar LLMs no contexto ESG
Outro trabalho dos pesquisadores da Federal Fluminense foi o “ESG-QA: Building a Dataset for Question Answering on Environmental, Social, and Governance Pillars“. Dataset com mais de 87 mil exemplos de perguntas, respostas e contextos sobre os três pilares do ESG.
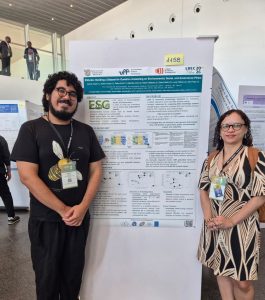
Ele foi construído combinado a filtros automáticos e validação humana, para explorar como os grandes modelos de linguagem (LLMs) lidam com temas relacionados a questões de meio ambiente, impacto social e governança (ESG).
Embora os três pilares do ESG sejam considerados cada vez mais relevantes para medir responsabilidade corporativa e sustentabilidade, ainda há poucos benchmarks para avaliar como os LLMs lidam com esse tema.
Na foto ao lado Gabriel Assis, coautor, e sua orientadora, Aline Paes, durante a apresentação do trabalho, na Itália.
Além do desenvolvimento do benchmark, os pesquisadores também avaliaram diferentes famílias de modelos abertos — Llama-3, Gemma-3 e Qwen-3. Para isso eles levaram em consideração a qualidade das respostas, o impacto ambiental e a clareza textual.
Os resultados deste trabalho indicaram melhor desempenho geral do Qwen-3 com recuperação de contexto, enquanto o Gemma-3 apresentou melhor equilíbrio entre qualidade, eficiência e legibilidade. Dessa forma, o ESG-QA se mostra como um benchmark muito importante para pesquisas em IA aplicada ao domínio ESG e para avaliações mais transparentes e responsáveis de modelos de linguagem.
A próxima edição da Newsletter do INCT TILDIAR traz outros trabalhos apresentados por pesquisadores do INCT TILDIAR.